La storia di Don Miller
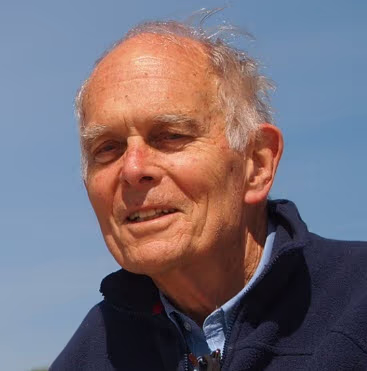
VoceVista è nato dai tentativi di Donald Miller di conciliare la sua carriera professionale di cantante e di insegnante con il suo interesse per l’acustica e la scienza della voce. Questo non significa che nel corso degli anni non ci siano state molte altre persone il cui contributo è stato essenziale per l’azienda.
Di seguito trovi il racconto in prima persona di come Don si è avvicinato alla ricerca sulla voce e di come VoceVista è diventato un punto di riferimento nel settore.
Scienza della voce e primi esperimenti
Nel 1964, dopo quattro anni di studi post-laurea e piccoli ingaggi professionali a Milano, Berlino e Vienna, e con una famiglia che cresceva, avevo bisogno di un «lavoro fisso». Ebbi la fortuna di ottenere un posto come insegnante di canto (in seguito professore di canto) alla Syracuse University (SU), dove rimasi felicemente per quasi 25 anni. Tra i vantaggi che trovai nel nord dello Stato di New York c’era la vicinanza alla Tri-Cities Opera, una compagnia rispettata nella vicina Binghamton, dove cantai ruoli da protagonista del repertorio tradizionale. Una fortuna ancora maggiore fu che la SU aveva avviato un’iniziativa sul modello della Voice Foundation, nata da poco, che usava tecnologie moderne per la ricerca in laringologia, in logopedia e, almeno potenzialmente, nella didattica del canto. Durante i miei primi anni in Europa avevo seguito il mio interesse per le lingue e avevo cominciato ad approfondire la fonetica (la produzione dei suoni del parlato), che mi portò poi a interessarmi di acustica e di scienza della voce. Nel laboratorio della SU, noi insegnanti di canto fummo invitati a osservare le nostre pliche vocali durante il canto mediante videostroboscopia, un’opportunità insolita a quei tempi.
Nell’ambito dell’iniziativa della Voice Foundation alla SU, l’insegnante di canto Jo Estill era arrivata come studentessa post-laurea. Il suo compito era approfondire il rapporto tra scienza della voce e canto, un interesse che lei e io condividevamo. Jo e il ricercatore in scienze del parlato Ray Colton tennero un workshop estivo di una settimana che offriva un’introduzione a chi si interessava all’argomento, con partecipanti in gran parte esterni all’università. Jo e io avemmo discussioni stimolanti, e a poco a poco trovai la strada verso i primi simposi della Voice Foundation a New York.
In quegli stessi anni, alla fine degli anni Settanta, fui ingaggiato come basso solista per l’esecuzione di un oratorio al Calvin College di Grand Rapids e conobbi il pedagogo Richard Miller dell’Oberlin Conservatory, che era il tenore solista. Invitai Miller a tenere un workshop alla SU e, mentre diventavamo amici, venni a sapere del suo lungo lavoro con Harm Schutte, otorinolaringoiatra e ricercatore di fisiologia della voce a Groninga, nei Paesi Bassi. Per coincidenza, Groninga era anche la città in cui lo stimato pedagogo della voce William Vennard aveva lavorato con lo scienziato della voce Janwillem van den Berg, autore della teoria mioelastico-aerodinamica della produzione vocale. Fu proprio dal periodo trascorso con van den Berg che Vennard trasse le basi per il suo apprezzatissimo libro Singing: The Mechanism and the Technic. Così, nel 1982, decisi di fare visita al prof. van den Berg, che mi presentò poi a Schutte. Entrambi organizzarono quindi per me un soggiorno a Groninga per il semestre primaverile del 1984. Ed è così che trascorsi il mio primo periodo sabbatico con il dott. Schutte, un otorinolaringoiatra. Vedevo il sabbatico come un’occasione unica per imparare il più possibile sulla scienza della voce con l’aiuto essenziale di un laringologo abilitato a eseguire procedure invasive.
Una di queste procedure, che Harm voleva sperimentare, consisteva nel far passare un catetere piuttosto rigido (originariamente destinato alle vie urinarie!) attraverso la commessura posteriore della glottide, permettendo di misurare direttamente le pressioni sottoglottiche e sopraglottiche, che variano rapidamente. Alcuni altri colleghi olandesi avevano usato quel protocollo sperimentale per la ricerca sul parlato, ma la nostra sarebbe stata la prima applicazione sistematica alla voce cantata. (Si rivelò anche l’ultima finora, per quanto ne so.)
A essere sincero, non avevo alcuna voglia di inghiottire il catetere e cercai di rimandare il più a lungo possibile, preferendo invece imparare altri aspetti delle procedure invasive (cioè la videolaringoscopia) e studiare la tesi di dottorato dello stesso Schutte sulle pressioni sottoglottiche. Schutte era riuscito a misurare la pressione sottoglottica media con un palloncino esofageo introdotto per via nasale e deglutito nell’esofago, una faccenda relativamente semplice che sembra molto peggio di quanto sia. Quando finalmente arrivammo alle misurazioni di pressione con il catetere rigido attraverso la commessura posteriore della glottide, il primo risultato fu che tossii parecchio, riuscendo a tenere la nota solo per brevi tratti. Temetti che l’esperimento fosse fallito, ma poi vidi la ‘splendida’ visualizzazione delle pressioni oscillanti sopra e sotto la glottide nei pochi momenti di fonazione sostenuta riuscita. Esaminati insieme al segnale elettroglottografico (EGG), che indica gli istanti di chiusura e di apertura della glottide, i risultati furono piuttosto soddisfacenti. Per evitare spasmi di tosse negli esperimenti successivi, scoprimmo che 15 minuti di riposo dopo l’inserimento del catetere erano di enorme aiuto. Usavo poi una sorta di suono [v] prima della vocale, che aiutava ulteriormente ad avviare una vibrazione regolare delle pliche vocali che proseguiva poi nella vocale tenuta. La procedura non diventò mai facile per me, ma vi tornammo per altre quattro lunghe sessioni, e riuscimmo perfino a raccogliere dati da altri cantanti professionisti e dilettanti disponibili.
I risultati di questi primi esperimenti furono davvero rivelatori. I dati di pressione, insieme ai dati EGG, mostravano che alla chiusura glottica la pressione sopraglottica era minima mentre quella sottoglottica era massima; l’impulso acustico di base era quindi negativo e produceva un’onda di rarefazione, non di compressione. Questo risultato contraddiceva il pensiero scientifico corrente dell’epoca. In quel momento della storia della scienza della voce, la comprensione intuitiva della produzione vocale presupponeva che la pressione sottoglottica aumentasse nella fase chiusa della glottide, facendo aprire di colpo le pliche vocali (la fase aperta), e che ne risultasse un treno di onde di pressione all’apertura glottica che generava la frequenza fondamentale quasi periodica. Si presupponeva che l’onda di pressione acustica cominciasse con una compressione, cioè un impulso positivo che forniva l’energia acustica della fonazione. Purtroppo van den Berg non condivise le nostre conclusioni e morì due anni dopo senza che la questione fosse risolta.
Ma si scoprì che non avevamo ancora del tutto finito con il catetere laringeo rigido. Schutte conosceva bene un’eccellente soprano professionista che era disposta a provare il nostro esperimento, ragionando che, se ce l’avevo fatta io, ce l’avrebbe fatta anche lei. Sembrava logico che l’adduzione glottica fosse per sua natura ridotta nel registro di ‘falsetto’ tipico del canto classico femminile, rispetto alla voce maschile operistica, in cui la zona acuta è prodotta in una sorta di registro di ‘petto’ modificato. Per questo il catetere nella commessura posteriore avrebbe dovuto essere un ostacolo minore durante la fonazione. Così fu, e il catetere non le creò grandi difficoltà in tutta l’estensione della voce cantata. La scoperta più sorprendente nei suoi dati fu questa: la variazione picco-picco misurata nella pressione sopraglottica includeva una breve fase in cui superava momentaneamente la pressione sottoglottica, il che suggeriva che il flusso d’aria attraverso la glottide si invertisse per un istante. Questa scoperta del tutto inattesa mi diede un’idea.
Avevo debuttato come relatore un anno prima, al simposio della Voice Foundation del giugno 1984, presentando risultati indicativi dei nostri esperimenti con van den Berg. L’anno seguente Gunnar Fant, un gigante della ricerca nella scienza della voce, annunciò una conferenza che si sarebbe tenuta sull’isola di Gotland, nel Mar Baltico. Furono invitati a partecipare i migliori scienziati della voce e clinici a livello internazionale, tra cui Ingo Titze e Johan Sundberg, che ammiravo per i simposi della Voice Foundation e per le loro ricerche pubblicate. Furono inclusi anche il noto ricercatore in scienze del parlato Martin Rothenberg, che avevo conosciuto come collega alla SU, e Harm Schutte. Gli invitati dovevano tenere una relazione. Ebbi l’idea che le nostre misurazioni delle pressioni sottoglottiche e sopraglottiche potessero essere all’altezza di quel gruppo, e proposi di scrivere un articolo che Harm avrebbe presentato. Anche se gli organizzatori erano un po’ riluttanti ad accettare la proposta, l’articolo fu accolto bene, con una menzione speciale da parte di Fant, e in seguito pubblicato. Ormai oltre la cinquantina, ebbi la sensazione di essermi imbucato in ritardo a una festa dei «pezzi grossi».
Harm Schutte e io proseguimmo proficue ricerche sulla voce cantata per i 25 anni successivi, contribuendo ogni anno ai simposi della Voice Foundation e pubblicando una serie di articoli su riviste con revisione paritaria. Nel 1987 lasciai la cattedra alla SU e mi trasferii a Groninga per dedicarmi a tempo pieno alla ricerca scientifica. In particolare, mi interessava profondamente capire come la tecnologia moderna potesse essere impiegata per arricchire l’insegnamento pratico del canto a lezione.
Le origini di VoceVista
Negli anni Novanta il computer era entrato nelle riflessioni del Groningen Voice Research Lab, ma io gli prestavo poca attenzione. Anzi, essendo nato nel 1933, ero ragionevolmente certo di aver superato l’età in cui mi sarei mai occupato di computer. Ma grazie a Harm Schutte, che mi guidò pazientemente nel processo di apprendimento, cambiai presto idea. In quel periodo i personal computer si erano evoluti al punto da poter eseguire l’analisi spettrale in ‘tempo reale’, offrendo una prova immediata degli effetti della sintonizzazione delle formanti sull’intensità relativa delle armoniche della sorgente vocale. (Le formanti sono le frequenze di risonanza dominanti e variabili del tratto vocale che producono i diversi suoni vocalici.) L’ospedale universitario di Groninga mise a disposizione di Harm le risorse per far realizzare un programma (in MS-DOS) che mostrasse e registrasse contemporaneamente il segnale del microfono, l’analisi spettrale e il segnale dell’elettroglottografo (EGG).
Desideroso di presentare questo nuovo strumento tecnologico agli insegnanti di canto, rimasi inizialmente sorpreso dal fatto che le nostre presentazioni ai simposi della Voice Foundation sembrassero suscitare scarso interesse tra i partecipanti. Per esempio, avevamo individuato nella «sintonizzazione delle formanti» una misura pratica fondamentale con cui i cantanti esperti, regolando le risonanze del tratto vocale, affrontavano con successo le difficoltà del «passaggio» nel produrre gli acuti culminanti dell’opera. Il problema di fondo deriva dal fatto che, man mano che la distanza tra le armoniche aumenta al crescere della frequenza fondamentale, la tecnologia per identificare automaticamente le frequenze delle formanti viene progressivamente meno. Quando però mostrammo che le frequenze delle formanti possono comunque essere identificate in modo affidabile, anche se non preciso, con un uso accorto del vocal fry, la notizia fu accolta con indifferenza. Questa reazione era forse prevedibile, dato che la competenza dell’insegnante di canto si manifesta nel sentire il risultato desiderato, più che nel vedere una visualizzazione delle armoniche della sorgente vocale. Ciononostante decisi di proseguire gli sforzi in questa linea di ricerca, che si dimostrava molto promettente nel mio insegnamento pratico. E anche se non ci fu una corsa entusiasta da parte di un folto gruppo di insegnanti di canto, ci fu un interesse entusiasta e profondo da parte di alcuni.
Jim Doing, un giovane tenore americano che nel 1996 viveva nei Paesi Bassi e a cui davo occasionalmente lezioni di canto, ottenne un posto come insegnante di canto all’Università del Missouri. Jim fu il primo cantante professionista a fare un uso deliberato del feedback visivo sulla sintonizzazione delle formanti durante le nostre lezioni. Quando gli chiesero quali fossero i suoi «interessi di ricerca», citò il nostro lavoro sulla sintonizzazione delle formanti e l’università rispose offrendosi di finanziare questa ricerca. Parte dei fondi servì a mandarmi, insieme a qualche ingombrante apparecchiatura, a lavorare con Jim e i suoi studenti per alcune settimane che si rivelarono fruttuose. Ricordo che Jim aveva in particolare uno studente tenore dalla voce straordinaria, che dimostrava splendidamente la manovra chiave del «passaggio» resa possibile da una sintonizzazione consapevole delle formanti.
Si dava anche il caso che John Stuart, un amico tenore con una notevole carriera operistica che si era stabilito alla Washington University di St. Louis, facesse parte del comitato organizzatore della successiva conferenza nazionale biennale della National Association of Teachers of Singing (NATS). John conosceva il mio lavoro e propose di dargli spazio nel programma. Così Jim Doing, il suo studente di punta e io andammo in auto da Kansas City, nel Missouri, a St. Louis, provando per tutto il tragitto la nostra presentazione del pomeriggio. La risposta fu positiva. Il noto baritono Ron Hedlund dichiarò di volere VoceVista per l’Università dell’Illinois (UIUC), e Dan Ihasz, un giovane cantante che insegnava alla SUNY Fredonia, espresse il suo entusiasmo e intraprese un percorso durato anni per padroneggiarne l’applicazione all’insegnamento del canto e alla propria tecnica vocale. Dan continua a usare VoceVista con i suoi studenti di canto e di didattica vocale a Fredonia, alcuni dei quali stanno ora costruendo a loro volta carriere di successo.
C’era anche Garyth Nair, direttore di coro, insegnante di canto e ricercatore in didattica alla Drew University di Madison, nel New Jersey, che fu tra i primi utenti di internet e un promotore delle nuove tecnologie. Avevo conosciuto Garyth nel 1997 al simposio della Voice Foundation, dove presentai il VoceVista originale. Dopo quel primo incontro decidemmo di lavorare insieme per rendere il software più facile da usare per gli insegnanti di canto. Un primo passo fu renderlo compatibile con Microsoft Windows, allora un sistema operativo nuovo. Garyth era già stato in contatto con l’ingegnere americano Richard Horne, che aveva messo su internet un programma gratuito di analisi spettrale. Bastò una semplice email per convincere Horne a incontrarci per parlare di VoceVista. Ma ci sarebbe stato un ulteriore colpo di scena. Oltre all’analisi spettrale, speravo di aggiungere al programma la funzionalità elettroglottografica (della Glottal Enterprises di Martin Rothenberg). E così fu Richard Horne a integrare in seguito sia il segnale acustico sia quello EGG nella versione originale di VoceVista per Windows.
Ma un serio ostacolo a una diffusione più ampia del sistema VoceVista restava l’alto prezzo dell’EGG, che all’epoca era progettato ed era disponibile solo per uso medico. Dopo alcune ricerche, Schutte riuscì a trovare un ingegnoso ingegnere olandese, Gerrie Goeree, che ricreò e fabbricò personalmente un EGG VoceVista unico nel suo genere, che forniva segnali con forme d’onda eccellenti, il tutto a un prezzo che cantanti e insegnanti di canto potevano permettersi.
Il decennio successivo portò miglioramenti al nostro software, soprattutto l’integrazione in VoceVista del software per spettrogrammi dello stesso Richard Horne. Questa nuova tecnologia permetteva di vedere in tempo reale le regolazioni di risonanza di un cantante, consentendo così di proiettare i segnali perché il pubblico potesse vedere i cambiamenti mentre il cantante li eseguiva. Fu poi nel giugno del 2007 che invitammo il pedagogo Scott McCoy, autore di Your Voice, an Inside View, a condurre la prima «masterclass cablata» in assoluto per alcuni studenti di Dan Ihasz a Fredonia. La masterclass fu un grande successo e Scott cominciò a usare il programma per conto proprio più tardi, quella stessa estate.
Sapendo che Scott aveva già pubblicato in proprio Your Voice, che fornisce le basi acustiche e fisiologiche della didattica vocale, cominciai a immaginare VoceVista come un’estensione e una realizzazione pratica della scienza della voce contenuta nel suo libro. Appena scelto come presidente entrante della NATS, Scott avrebbe avuto voce in capitolo sui contenuti del programma della conferenza biennale del 2008 a Nashville, e prese la coraggiosa decisione di aprire il programma con una masterclass cablata con VoceVista. Questo sviluppo mi fece vedere un’occasione importante, se non un obbligo, di scrivere un libro che potesse servire da manuale esteso per l’uso di VoceVista e dell’EGG, in tempo per essere disponibile alla conferenza della NATS. Chiesi a Scott se fosse disposto a curarlo e pubblicarlo, e lui accettò senza esitazione. Così cominciai a lavorare a una bozza di Resonance in Singing.
La stesura vera e propria di Resonance in Singing procedette senza intoppi, perché avevo già trattato gran parte dei contenuti in una serie di articoli pubblicati, confluiti nella mia tesi di dottorato in Scienze mediche (Università di Groninga, 2000) intitolata Registers in Singing: Empirical and Systematic Studies in the Theory of the Singing Voice. Scott si rivelò un curatore disponibile e tempestivo, pur ricoprendo un incarico di docente a tempo pieno al Westminster Choir College e la presidenza della NATS. Anche se la scrittura fu interrotta per breve tempo da un’appendicectomia d’urgenza nella primavera del 2008, il libro fu pronto in tempo per la conferenza di Nashville, dove la masterclass cablata con VoceVista sarebbe stata il primo punto plenario in programma.
Credo si possa dire che pochi tra il pubblico capirono fino in fondo ciò che fu presentato in quella masterclass abbreviata, ma il legame tra didattica e scienza della voce era evidente. Un piccolo gruppo di insegnanti di canto interessati (ci soprannominammo «Fryers», dall’uso del vocal fry per individuare le formanti) continuò a scambiarsi informazioni e idee, promuovendo i nostri workshop biennali sulla fisiologia e l’acustica del canto (Physiology and Acoustics of Singing, PAS) a San Antonio, Stoccolma e Las Vegas (dopo i workshop precedenti a Groninga e Denver).
Il software di analisi acustica di base con l’aggiunta dell’EGG prese il nome di VoceVista Pro e, insieme al libro Resonance in Singing, continua a essere uno strumento importante per gli insegnanti di canto di tutto il mondo. È alla base di una tesi di dottorato, di prossima pubblicazione, di Stephen Robertson, responsabile degli studi di canto al Royal Conservatoire of Scotland. La tesi tratta il suo uso del programma nell’insegnamento agli studenti, oltre a dati analizzati di professionisti affermati del circuito operistico internazionale.
Pur guadagnando popolarità nel mondo della didattica vocale, VoceVista stava per attraversare un altro periodo di cambiamento. Bodo Maass, che aveva creato il programma Overtone Analyzer, si offrì di aggiornare e migliorare il software VoceVista, aggiungendo un segnale video ai segnali audio ed EGG di base, insieme ad altri progressi tecnologici. Attualmente (gennaio 2020) siamo nella dirittura d’arrivo verso il prodotto finito e stiamo inoltre lavorando a un’ampia revisione per la seconda edizione di Resonance in Singing, per allinearla agli aggiornamenti di VoceVista Video Pro.