Historia Dona Millera
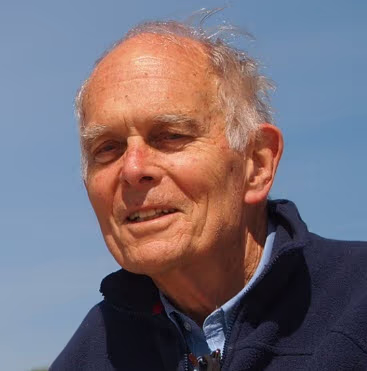
VoceVista narodziła się z prób połączenia przez Donalda Millera kariery zawodowego śpiewaka i nauczyciela z zainteresowaniem akustyką i nauką o głosie. Nie oznacza to, że przez lata nie było wielu innych osób, których wkład był dla firmy kluczowy.
Poniżej znajduje się relacja w pierwszej osobie o tym, jak Don zainteresował się badaniami nad głosem i jak VoceVista wyrosła na lidera w tej dziedzinie.
Nauka o głosie i pierwsze eksperymenty
W 1964 roku, po czterech latach studiów podyplomowych i drobnych zawodowych angaży w Mediolanie, Berlinie i Wiedniu, mając coraz liczniejszą rodzinę, potrzebowałem „stałej pracy”. Miałem szczęście dostać posadę instruktora śpiewu (później profesora śpiewu) na Syracuse University (SU), gdzie z radością pozostałem przez blisko 25 lat. Jedną z zalet, jakie odkryłem w północnej części stanu Nowy Jork, była bliskość Tri-Cities Opera, cenionego zespołu w pobliskim Binghamton, gdzie śpiewałem główne role ze standardowego repertuaru. Jeszcze większym zrządzeniem losu było to, że uniwersytet uruchomił inicjatywę wzorowaną na niedawno utworzonej Voice Foundation, wykorzystującą najnowszą technologię do badań w dziedzinie laryngologii, logopedii i, przynajmniej potencjalnie, nauczania śpiewu. W czasie wcześniejszych lat w Europie podążałem za swoim zainteresowaniem językami i zacząłem wnikliwiej zajmować się fonetyką (wytwarzaniem dźwięków mowy), co z kolei doprowadziło mnie do zainteresowania akustyką i nauką o głosie. W laboratorium SU nas, nauczycieli śpiewu, zaproszono do obserwowania naszych fałdów głosowych podczas śpiewu za pomocą wideostroboskopii, co było w tamtych czasach niezwykłą okazją.
W związku z inicjatywą Voice Foundation na SU pojawiła się jako studentka studiów podyplomowych nauczycielka śpiewu Jo Estill. Jej zadaniem było badanie związku między nauką o głosie a śpiewem, a to zainteresowanie oboje podzielaliśmy. Jo i badacz mowy Ray Colton prowadzili tygodniowe warsztaty letnie, stanowiące wprowadzenie dla zainteresowanych tematem, w których uczestniczyły głównie osoby spoza uniwersytetu. Jo i ja prowadziliśmy inspirujące dyskusje, a ja stopniowo trafiłem na pierwsze sympozja Voice Foundation w Nowym Jorku.
W tych samych latach, pod koniec lat 70., zaangażowano mnie jako solistę basowego do wykonania oratorium w Calvin College w Grand Rapids, gdzie poznałem pedagoga Richarda Millera z Oberlin Conservatory, który był solistą tenorowym. Zaprosiłem Millera na warsztaty na SU, a gdy się zaprzyjaźniliśmy, dowiedziałem się o jego wieloletniej współpracy z Harmem Schuttem, otolaryngologiem i badaczem fizjologii głosu z Groningen w Holandii. Tak się złożyło, że to właśnie w Groningen ceniony pedagog głosu William Vennard pracował z badaczem głosu Janwillemem van den Bergiem, autorem mioelastyczno-aerodynamicznej teorii wytwarzania głosu. To czas spędzony z van den Bergiem dał Vennardowi podstawy jego wysoko cenionej książki Singing: The Mechanism and the Technic. Dlatego w 1982 roku postanowiłem odwiedzić prof. van den Berga, który przedstawił mnie Schuttemu. Obaj zorganizowali mi następnie pobyt w Groningen w semestrze wiosennym 1984 roku. I tak spędziłem swój pierwszy urlop naukowy u dr. Schuttego, otolaryngologa. Widziałem w tym urlopie niepowtarzalną okazję, by dowiedzieć się jak najwięcej o nauce o głosie przy nieocenionej pomocy laryngologa uprawnionego do przeprowadzania zabiegów inwazyjnych.
Jeden z takich zabiegów, który Harm chciał wypróbować, polegał na przeprowadzeniu dość sztywnego cewnika (pierwotnie przeznaczonego do dróg moczowych!) przez spoidło tylne głośni, co pozwalało bezpośrednio mierzyć szybko zmieniające się ciśnienie pod- i nadgłośniowe. Kilku innych holenderskich kolegów stosowało ten protokół eksperymentalny w badaniach mowy, ale nasze badanie miało być pierwszym systematycznym zastosowaniem go do głosu śpiewaczego. (Okazało się też, o ile wiem, jak dotąd ostatnim.)
Szczerze mówiąc, nie cieszyłem się na połykanie cewnika i jak najdłużej tego unikałem, woląc zamiast tego poznawać inne aspekty zabiegów inwazyjnych (np. wideolaryngoskopię), a także pracę doktorską samego Schuttego dotyczącą ciśnienia podgłośniowego. Schuttemu udało się zmierzyć średnie ciśnienie podgłośniowe za pomocą balonika przełykowego wprowadzanego przez nos i połykanego do przełyku, co jest stosunkowo nieskomplikowaną procedurą, która brzmi znacznie gorzej, niż wygląda w rzeczywistości. Kiedy w końcu zabraliśmy się do pomiarów ciśnienia twardym cewnikiem przez spoidło tylne głośni, pierwszym skutkiem był głównie mój kaszel i tylko krótkie odcinki utrzymanej wysokości dźwięku. Obawiałem się, że eksperyment się nie powiódł, ale wtedy zobaczyłem „piękny” obraz oscylujących ciśnień nad głośnią i pod nią w tych kilku utrzymanych chwilach udanej fonacji. W zestawieniu z sygnałem elektroglottograficznym (EGG), który wskazuje momenty zamykania i otwierania głośni, wyniki okazały się całkiem satysfakcjonujące. Odkryliśmy, że aby uniknąć ataków kaszlu w kolejnych eksperymentach, ogromnie pomaga 15 minut odpoczynku po wprowadzeniu cewnika. Następnie stosowałem przed samogłoską coś w rodzaju dźwięku [v], co dodatkowo pomagało zainicjować płynne drgania fałdów głosowych, które przechodziły potem w utrzymaną samogłoskę. Procedura nigdy nie stała się dla mnie łatwa, ale wróciliśmy do niej podczas czterech kolejnych długich sesji i udało nam się nawet zebrać dane od innych dostępnych śpiewaków zawodowych i amatorów.
Wyniki tych wczesnych eksperymentów były bardzo odkrywcze. Dane dotyczące ciśnienia wraz z danymi EGG pokazały, że w chwili zamykania głośni ciśnienie nadgłośniowe było minimalne, a podgłośniowe maksymalne; zatem podstawowy impuls akustyczny był ujemny i wytwarzał falę rozrzedzenia, a nie zagęszczenia. Wynik ten przeczył powszechnym wówczas poglądom naukowym. Na tamtym etapie historii nauki o głosie intuicyjne rozumienie wytwarzania głosu zakładało, że ciśnienie podgłośniowe wzrasta w fazie zamknięcia głośni, powodując gwałtowne rozwarcie fałdów głosowych (faza otwarcia), co prowadzi do powstania ciągu fal ciśnienia w chwili otwarcia głośni, generujących quasi-okresową częstotliwość podstawową. Zakładano, że akustyczna fala ciśnienia zaczyna się od zagęszczenia, czyli dodatniego impulsu, który dostarcza energii akustycznej fonacji. Niestety van den Berg nie poparł naszych wniosków i zmarł dwa lata później, nie rozstrzygnąwszy tej kwestii.
Okazało się jednak, że nie skończyliśmy jeszcze ze sztywnym cewnikiem krtaniowym. Schutte dobrze znał znakomitą zawodową sopranistkę, która była gotowa spróbować naszego eksperymentu, rozumując, że skoro ja dałem radę, to i ona da. Wydawało się logiczne, że przywodzenie fałdów głosowych będzie z natury mniejsze w rejestrze „falsetowym”, typowym dla klasycznego śpiewu kobiecego, niż w operowym głosie męskim, w którym górny zakres wytwarzany jest w pewnym rodzaju zmodyfikowanego rejestru „piersiowego”. Z tego powodu cewnik w spoidle tylnym powinien stanowić mniejszą przeszkodę podczas fonacji. Okazało się to prawdą i cewnik nie sprawiał jej większych trudności w całym zakresie głosu śpiewaczego. Szczególnie zaskakujące w jej danych było to, że międzyszczytowa zmienność zmierzonego ciśnienia nadgłośniowego obejmowała krótką fazę, w której chwilowo przewyższało ono ciśnienie podgłośniowe, co sugerowało, że przepływ powietrza przez głośnię na moment się odwracał. To zupełnie nieoczekiwane odkrycie podsunęło mi pewien pomysł.
Rok wcześniej, w czerwcu 1984 roku, zadebiutowałem jako prelegent na sympozjum Voice Foundation, przedstawiając obiecujące wyniki naszych eksperymentów z van den Bergiem. W następnym roku Gunnar Fant, gigant badań nad głosem, ogłosił konferencję, która miała się odbyć na Gotlandii, wyspie na Morzu Bałtyckim. Zaproszono na nią czołowych międzynarodowych badaczy głosu i klinicystów, w tym Ingo Titzego i Johana Sundberga, których podziwiałem zarówno z sympozjów Voice Foundation, jak i z ich publikacji. Zaproszono również znanego badacza mowy Martina Rothenberga, którego poznałem jako kolegę z SU, oraz Harma Schuttego. Od zaproszonych oczekiwano wystąpień. Wpadłem na pomysł, że nasze pomiary ciśnienia pod- i nadgłośniowego mogą być godne tego grona, i zaproponowałem napisanie referatu, który wygłosiłby Harm. Choć organizatorzy dość niechętnie przyjęli tę propozycję, referat spotkał się z dobrym odbiorem, Fant szczególnie go wyróżnił, a później został on opublikowany. Już po pięćdziesiątce miałem poczucie, że z opóźnieniem wprosiłem się na przyjęcie „wielkich chłopców”.
Harm Schutte i ja przez kolejne 25 lat prowadziliśmy owocne badania głosu śpiewaczego, co roku występując na sympozjach Voice Foundation i publikując serię artykułów w recenzowanych czasopismach. W 1987 roku zrezygnowałem z profesury na SU i przeprowadziłem się do Groningen, aby w pełni poświęcić się badaniom naukowym. Szczególnie interesowało mnie, jak nowoczesna technologia może wspierać praktyczne nauczanie śpiewu na lekcjach.
Początki VoceVista
W latach 90. komputer pojawił się w planach laboratorium badań nad głosem w Groningen, ale nie poświęcałem mu wiele uwagi. Prawdę mówiąc, urodzony w 1933 roku, byłem dość pewien, że jestem już w wieku, w którym nigdy nie zajmę się komputerami. Ale dzięki Harmowi Schuttemu, który cierpliwie prowadził mnie przez proces nauki, szybko zmieniłem zdanie. Komputery osobiste rozwinęły się mniej więcej wtedy do tego stopnia, że mogły wykonywać analizę spektrum „w czasie rzeczywistym”, dając natychmiastowy obraz wpływu strojenia formantów na względną siłę harmonicznych źródła głosu. (Formanty to zmienne dominujące częstotliwości rezonansowe traktu głosowego, które wytwarzają poszczególne samogłoski.) Szpital Uniwersytecki w Groningen zapewnił Harmowi środki na stworzenie programu komputerowego (w MS-DOS), który jednocześnie pokazywał i rejestrował sygnał mikrofonu, analizę spektrum i sygnał elektroglottografu (EGG).
Chcąc jak najszybciej przedstawić to nowe narzędzie technologiczne nauczycielom śpiewu, byłem początkowo zaskoczony, że nasze prezentacje na sympozjach Voice Foundation wzbudzały wśród uczestników niewielkie zainteresowanie. Na przykład wskazaliśmy „strojenie formantów” jako kluczowy praktyczny sposób, w jaki wprawni śpiewacy, dostosowując rezonanse traktu głosowego, skutecznie radzą sobie z wyzwaniami „passaggio” przy wydobywaniu kulminacyjnych wysokich dźwięków w operze. Zasadniczy problem wynika z tego, że gdy wraz ze wzrostem częstotliwości podstawowej rosną odstępy między harmonicznymi, technologia automatycznej identyfikacji częstotliwości formantów stopniowo zawodzi. Kiedy jednak pokazaliśmy, że częstotliwości formantów można mimo to wiarygodnie, choć nie precyzyjnie, określić dzięki umiejętnemu użyciu rejestru vocal fry, wiadomość ta spotkała się z obojętnością. Takiej reakcji można się było chyba spodziewać, ponieważ biegłość nauczyciela śpiewu przejawia się w słyszeniu pożądanego rezultatu, a nie w oglądaniu wizualnego obrazu harmonicznych źródła głosu. Mimo to postanowiłem kontynuować wysiłki w tym kierunku badań, który okazywał się bardzo obiecujący w mojej własnej praktyce nauczycielskiej. I choć nie było entuzjastycznego szturmu ze strony dużej grupy nauczycieli śpiewu, kilku z nich wykazało entuzjastyczne, głębokie zainteresowanie.
Jim Doing, młody amerykański tenor, który w 1996 roku mieszkał w Holandii i któremu od czasu do czasu udzielałem lekcji śpiewu, dostał posadę nauczyciela śpiewu na Uniwersytecie Missouri. Jim był pierwszym zawodowym śpiewakiem, który podczas naszych wspólnych lekcji świadomie korzystał z wizualnej informacji zwrotnej o strojeniu formantów. Zapytany o swoje „zainteresowania badawcze”, wspomniał o naszej pracy nad strojeniem formantów, a uniwersytet zaproponował sfinansowanie takich badań. Część środków przeznaczono na to, by wysłać mnie wraz z nieporęczną aparaturą do pracy z Jimem i jego studentami na kilka tygodni, które okazały się bardzo udane. Pamiętam, że Jim miał zwłaszcza jednego studenta, tenora o niezwykłym głosie, który pięknie zademonstrował kluczowy manewr „passaggio”, możliwy dzięki świadomemu strojeniu formantów.
Zdarzyło się też, że John Stuart, zaprzyjaźniony tenor o znaczącej karierze operowej, który osiadł na Washington University w St. Louis, zasiadał w komitecie programowym zbliżającej się, odbywającej się co dwa lata ogólnokrajowej konferencji National Association of Teachers of Singing (NATS). John znał moją pracę i zaproponował, by znalazło się dla niej miejsce w programie. Tak więc Jim Doing, jego najzdolniejszy student i ja pojechaliśmy samochodem z Kansas City w stanie Missouri do St. Louis, przez całą drogę ćwicząc w aucie naszą popołudniową prezentację. Reakcja była pozytywna. Znany baryton Ron Hedlund oświadczył, że chce VoceVista dla University of Illinois (UIUC), a Dan Ihasz, młody śpiewak uczący na SUNY Fredonia, wyraził swój entuzjazm i rozpoczął trwający wiele lat proces opanowywania zastosowania programu w nauczaniu śpiewu i we własnej technice wokalnej. Dan nadal korzysta z VoceVista ze swoimi studentami śpiewu i pedagogiki we Fredonii, z których niektórzy budują już własne udane kariery.
Był też Garyth Nair, dyrygent chóralny, nauczyciel śpiewu i badacz pedagogiki na Drew University w Madison w stanie New Jersey, który wcześnie zaczął korzystać z internetu i propagował nowe technologie. Poznałem Garytha w 1997 roku na sympozjum Voice Foundation, gdzie zaprezentowałem pierwotną wersję VoceVista. Po tym pierwszym spotkaniu postanowiliśmy wspólnie pracować nad tym, by program był bardziej przyjazny dla nauczycieli śpiewu. Pierwszym krokiem było dostosowanie go do systemu Microsoft Windows, który był wówczas nowym systemem operacyjnym. Garyth był już wcześniej w kontakcie z amerykańskim inżynierem Richardem Horne’em, który udostępnił w internecie bezpłatny program do analizy spektrum. Wystarczyło proste zapytanie e-mailem, by Horne zgodził się na spotkanie w sprawie VoceVista. Sprawa miała jednak przybrać dodatkowy obrót. Oprócz analizy spektrum chciałem dodać do programu obsługę elektroglottografu (z firmy Glottal Enterprises Martina Rothenberga). I tak to właśnie Richard Horne zintegrował później zarówno sygnał akustyczny, jak i sygnał EGG w pierwszej wersji VoceVista dla systemu Windows.
Poważną przeszkodą dla szerszego wykorzystania systemu VoceVista pozostawała jednak wysoka cena EGG, który w tamtym czasie projektowano i oferowano wyłącznie do zastosowań medycznych. Po pewnych poszukiwaniach Schuttemu udało się znaleźć pomysłowego holenderskiego inżyniera, Gerriego Goeree, który odtworzył i osobiście wyprodukował unikatowy VoceVista EGG, dający sygnały o doskonałym przebiegu, a wszystko to w cenie, na którą mogli sobie pozwolić śpiewacy i nauczyciele śpiewu.
Kolejna dekada przyniosła ulepszenia naszego oprogramowania, przede wszystkim zintegrowanie przez Richarda Horne’a jego własnego programu do spektrogramów z VoceVista. Ta nowa technologia umożliwiła oglądanie zmian rezonansów śpiewaka w czasie rzeczywistym, dzięki czemu sygnały można było wyświetlać publiczności, która widziała zmiany w chwili, gdy śpiewak je wprowadzał. To właśnie w czerwcu 2007 roku zaprosiliśmy pedagoga Scotta McCoya, autora książki Your Voice, an Inside View, do poprowadzenia pierwszego w historii „okablowanego kursu mistrzowskiego” dla kilku studentów Dana Ihasza we Fredonii. Zajęcia okazały się wielkim sukcesem, a Scott jeszcze tego samego lata zaczął samodzielnie korzystać z programu.
Wiedząc, że Scott wydał wcześniej własnym nakładem Your Voice, książkę dającą akustyczne i fizjologiczne podstawy pedagogiki wokalnej, zacząłem postrzegać VoceVista jako rozwinięcie i praktyczną realizację nauki o głosie zawartej w jego książce. Niedawno wybrany na kolejnego prezesa NATS, Scott miał mieć wpływ na program odbywającej się co dwa lata konferencji w Nashville w 2008 roku, więc podjął odważną decyzję, by rozpocząć program okablowanym kursem mistrzowskim z użyciem VoceVista. Dzięki temu dostrzegłem ważną okazję, jeśli nie obowiązek, napisania książki, która mogłaby służyć jako rozszerzony podręcznik korzystania z VoceVista i EGG i byłaby gotowa na czas konferencji NATS. Zapytałem Scotta, czy zgodziłby się ją zredagować i wydać, a on bez wahania się zgodził. Tak zacząłem pracę nad szkicem Resonance in Singing.
Samo pisanie Resonance in Singing szło gładko, ponieważ większość treści omówiłem już w serii opublikowanych artykułów, które złożyły się na moją rozprawę doktorską z nauk medycznych (Uniwersytet w Groningen, 2000) zatytułowaną Registers in Singing: Empirical and Systematic Studies in the Theory of the Singing Voice. Scott okazał się pomocnym i sprawnym redaktorem, mimo że pracował na pełnym etacie jako wykładowca w Westminster Choir College i pełnił funkcję prezesa NATS. Choć pisanie na chwilę przerwała nagła operacja wyrostka robaczkowego wiosną 2008 roku, książka była gotowa na czas konferencji w Nashville, gdzie okablowany kurs mistrzowski z VoceVista miał otworzyć program jako pierwszy punkt sesji plenarnej.
Myślę, że można śmiało powiedzieć, iż niewielu słuchaczy w pełni zrozumiało to, co przedstawiono podczas tego skróconego kursu mistrzowskiego, ale związek pedagogiki z nauką o głosie był oczywisty. Niewielka grupa zainteresowanych nauczycieli śpiewu (nazwaliśmy się żartobliwie „Fryers”, od używania vocal fry do lokalizowania formantów) nadal wymieniała się informacjami i spostrzeżeniami, promując nasze odbywające się co dwa lata warsztaty Physiology and Acoustics of Singing (PAS) w San Antonio, Sztokholmie i Las Vegas (po wcześniejszych warsztatach w Groningen i Denver).
Podstawowe oprogramowanie do analizy akustycznej z dodaną obsługą EGG stało się znane jako VoceVista Pro i wraz z książką Resonance in Singing nadal jest ważnym narzędziem dla nauczycieli śpiewu na całym świecie. Stanowi podstawę mającej się wkrótce ukazać rozprawy doktorskiej Stephena Robertsona, kierownika studiów wokalnych w Royal Conservatoire of Scotland. Rozprawa omawia wykorzystanie programu w nauczaniu studentów, a także przeanalizowane dane od uznanych zawodowców z międzynarodowej sceny operowej.
Choć VoceVista zyskiwała popularność w świecie pedagogiki wokalnej, wkrótce czekał ją kolejny okres zmian. Bodo Maass, twórca programu Overtone Analyzer, zaproponował aktualizację i ulepszenie oprogramowania VoceVista, dodając do podstawowych sygnałów audio i EGG sygnał wideo, a także inne udoskonalenia technologiczne. Obecnie (styczeń 2020) jesteśmy na ostatniej prostej przed ukończeniem produktu, a ponadto pracujemy nad gruntowną redakcją drugiego wydania Resonance in Singing, aby dostosować je do zmian w VoceVista Video Pro.