Don Millers Geschichte
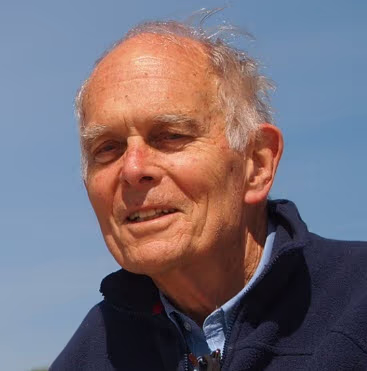
VoceVista entstand aus Donald Millers Bestreben, seine Laufbahn als professioneller Sänger und Gesangslehrer mit seinem Interesse an Akustik und Stimmwissenschaft zu verbinden. Das soll nicht heißen, dass nicht auch viele andere Menschen im Lauf der Jahre Wesentliches zum Unternehmen beigetragen hätten.
Im Folgenden erzählt Don selbst, wie er zur Stimmforschung kam und wie VoceVista zu einer führenden Größe auf diesem Gebiet wurde.
Stimmwissenschaft und frühe Experimente
1964, nach vier Jahren Aufbaustudium und kleineren Engagements in Mailand, Berlin und Wien, und mit einer wachsenden Familie, brauchte ich eine „feste Stelle“. Zu meinem Glück bekam ich eine Stelle als Gesangslehrer (später Professor für Gesang) an der Syracuse University (SU), wo ich fast 25 Jahre lang gern blieb. Zu den Vorzügen, die ich im Norden des Bundesstaats New York vorfand, gehörte die Nähe zur Tri-Cities Opera, einem angesehenen Opernhaus im nahen Binghamton, wo ich Hauptrollen des gängigen Repertoires sang. Ein noch größerer Glücksfall war, dass die SU eine Initiative nach dem Vorbild der kurz zuvor gegründeten Voice Foundation ins Leben gerufen hatte, die moderne Technik für die Forschung in Laryngologie, Logopädie und, zumindest potenziell, im Gesangsunterricht einsetzte. In meinen früheren Jahren in Europa war ich meinem Interesse an Sprachen gefolgt und hatte begonnen, mich eingehender mit Phonetik (der Bildung von Sprachlauten) zu beschäftigen, was mich dann zur Akustik und Stimmwissenschaft führte. Im Labor der SU durften wir Gesangslehrer unsere Stimmlippen beim Singen per Videostroboskopie beobachten, damals eine ungewöhnliche Gelegenheit.
Im Zusammenhang mit der Voice-Foundation-Initiative an der SU war die Gesangslehrerin Jo Estill für ein Aufbaustudium gekommen. Ihre Aufgabe war es, der Beziehung zwischen Stimmwissenschaft und Gesang nachzugehen, ein Interesse, das wir beide teilten. Jo und der Sprechwissenschaftler Ray Colton boten einen einwöchigen Sommerworkshop an, der Interessierten eine Einführung in das Thema gab. Die Teilnehmer kamen größtenteils von außerhalb der Universität. Jo und ich führten anregende Gespräche, und so fand ich allmählich meinen Weg zu den frühen Symposien der Voice Foundation in New York City.
In denselben Jahren, Ende der 1970er, war ich als Bass-Solist für eine Oratorienaufführung am Calvin College in Grand Rapids engagiert und lernte dort den Pädagogen Richard Miller vom Oberlin Conservatory kennen, der das Tenorsolo sang. Ich lud Miller zu einem Workshop an die SU ein, und als wir Freunde wurden, erfuhr ich von seiner langjährigen Zusammenarbeit mit Harm Schutte, einem Hals-Nasen-Ohren-Arzt und Forscher auf dem Gebiet der Stimmphysiologie in Groningen in den Niederlanden. Zufällig hatte in Groningen auch der angesehene Gesangspädagoge William Vennard mit dem Stimmwissenschaftler Janwillem van den Berg gearbeitet, dem Urheber der myoelastisch-aerodynamischen Theorie der Stimmerzeugung. Aus seiner Zeit bei van den Berg schöpfte Vennard die Grundlage für sein hoch geschätztes Buch Singing: The Mechanism and the Technic. Also beschloss ich 1982, Prof. van den Berg zu besuchen, der mich dann mit Schutte bekannt machte. Die beiden sorgten dafür, dass ich das Frühjahrssemester 1984 in Groningen verbringen konnte. So kam es, dass ich mein erstes Sabbatical bei Dr. Schutte verbrachte, einem Hals-Nasen-Ohren-Arzt. Ich sah darin eine einzigartige Gelegenheit, so viel wie möglich über Stimmwissenschaft zu lernen, mit der unverzichtbaren Hilfe eines Laryngologen, der invasive Eingriffe vornehmen durfte.
Einer dieser Eingriffe, den Harm ausprobieren wollte, bestand darin, einen ziemlich starren Katheter (eigentlich für die Harnwege gedacht!) durch die hintere Kommissur der Glottis zu führen, sodass sich die schnell wechselnden sub- und supraglottischen Drücke direkt messen ließen. Einige niederländische Kollegen hatten dieses Versuchsprotokoll bereits in der Sprachforschung eingesetzt, aber unsere Studie sollte die erste systematische Anwendung auf die Singstimme werden. (Soweit ich weiß, ist sie bis heute auch die letzte geblieben.)
Ehrlich gesagt freute ich mich nicht gerade darauf, den Katheter zu schlucken, und schob es so lange wie möglich hinaus. Stattdessen beschäftigte ich mich lieber mit anderen Aspekten invasiver Verfahren (d. h. der Videolaryngoskopie) und mit Schuttes eigener Dissertation über den subglottischen Druck. Schutte hatte den mittleren subglottischen Druck erfolgreich mit einem Ösophagusballon gemessen, der durch die Nase eingeführt und in die Speiseröhre geschluckt wird, eine relativ unkomplizierte Angelegenheit, die viel schlimmer klingt, als sie ist. Als wir uns schließlich an die Druckmessungen mit dem harten Katheter durch die hintere Kommissur der Glottis machten, bestand das erste Ergebnis vor allem aus viel Husten meinerseits, mit nur kurzen Abschnitten gehaltener Töne. Ich fürchtete schon, das Experiment sei gescheitert, doch dann sah ich die ‚wunderschöne‘ Darstellung der schwingenden Drücke ober- und unterhalb der Glottis in den wenigen gehaltenen Momenten gelungener Phonation. Zusammen mit dem elektroglottographischen Signal (EGG) betrachtet, das die Zeitpunkte des Schließens und Öffnens der Glottis anzeigt, waren die Ergebnisse recht zufriedenstellend. Um bei weiteren Experimenten Hustenanfälle zu vermeiden, stellten wir fest, dass 15 Minuten Ruhe nach dem Einführen des Katheters enorm halfen. Außerdem setzte ich eine Art [v]-Laut vor den Vokal, was zusätzlich half, eine gleichmäßige Schwingung der Stimmlippen einzuleiten, die dann in den gehaltenen Vokal überging. Leicht wurde mir die Prozedur nie, aber wir wiederholten sie in vier weiteren ausgedehnten Sitzungen und konnten sogar Daten von anderen verfügbaren Berufs- und Laiensängern erheben.
Die Ergebnisse dieser frühen Experimente waren sehr aufschlussreich. Die Druckdaten zeigten zusammen mit den EGG-Daten, dass beim Glottisschluss der supraglottische Druck minimal und der subglottische Druck maximal war; der grundlegende akustische Impuls war also negativ und erzeugte eine Verdünnungswelle, keine Verdichtungswelle. Dieses Ergebnis widersprach der damals gängigen wissenschaftlichen Auffassung. Zu jener Zeit ging das intuitive Verständnis der Stimmerzeugung davon aus, dass der subglottische Druck in der Schlussphase der Glottis ansteigt und die Stimmlippen aufsprengt (die Öffnungsphase), sodass bei der Öffnung der Glottis eine Folge von Druckwellen entsteht, die die quasiperiodische Grundfrequenz erzeugt. Man nahm an, dass die akustische Druckwelle mit einer Verdichtung beginnt, also mit einem positiven Impuls, der die akustische Energie der Stimmgebung liefert. Leider unterstützte van den Berg unsere Schlussfolgerungen nicht, und er starb zwei Jahre später, ohne dass die Frage geklärt war.
Doch wie sich zeigte, waren wir mit dem starren Larynxkatheter noch nicht ganz fertig. Schutte kannte eine ausgezeichnete professionelle Sopranistin gut, die bereit war, sich auf unser Experiment einzulassen, nach dem Motto: Wenn ich es schaffte, würde sie es auch schaffen. Es schien logisch, dass die glottale Adduktion im ‚Falsett‘-Register, das für den klassischen Frauengesang typisch ist, von Natur aus geringer ist als bei der Opernstimme des Mannes, bei der die Höhe in einer Art modifiziertem ‚Brust‘-Register gebildet wird. Daher sollte der Katheter in der hinteren Kommissur die Phonation weniger behindern. Genau so war es: Der Katheter bereitete ihr im gesamten Umfang der Singstimme keine großen Schwierigkeiten. Besonders überraschend an ihren Daten war Folgendes: Die gemessene Spitze-Spitze-Schwankung des supraglottischen Drucks enthielt eine kurze Phase, in der er den subglottischen Druck für einen Moment überstieg, was darauf hindeutete, dass sich der Luftstrom durch die Glottis kurzzeitig umkehrte. Dieser völlig unerwartete Befund brachte mich auf eine Idee.
Ein Jahr zuvor, im Juni 1984, hatte ich beim Symposium der Voice Foundation mein Debüt als Vortragender gegeben und über vielversprechende Ergebnisse unserer Experimente mit van den Berg berichtet. Im folgenden Jahr kündigte Gunnar Fant, ein Gigant der stimmwissenschaftlichen Forschung, eine Konferenz auf der Ostseeinsel Gotland an. Eingeladen waren führende internationale Stimmwissenschaftler und Kliniker, darunter Ingo Titze und Johan Sundberg, die ich von den Symposien der Voice Foundation und aus ihren Veröffentlichungen kannte und bewunderte. Außerdem gehörten der namhafte Sprechwissenschaftler Martin Rothenberg, den ich als Kollegen an der SU kennengelernt hatte, und Harm Schutte dazu. Von den Eingeladenen wurde erwartet, dass sie Vorträge hielten. Mir kam der Gedanke, dass unsere sub- und supraglottischen Druckmessungen dieses Kreises würdig sein könnten, und ich schlug vor, einen Beitrag zu schreiben, den Harm vortragen würde. Die Organisatoren nahmen den Vorschlag zwar etwas zögerlich an, doch der Beitrag wurde gut aufgenommen, von Fant eigens hervorgehoben und anschließend veröffentlicht. Mit über fünfzig hatte ich das Gefühl, mich reichlich spät auf eine Party der „großen Jungs“ geschmuggelt zu haben.
Harm Schutte und ich setzten unsere ergiebigen Untersuchungen der Singstimme in den folgenden 25 Jahren fort, mit jährlichen Beiträgen zu den Symposien der Voice Foundation und einer Reihe von Artikeln in Fachzeitschriften mit Peer-Review. 1987 gab ich meine Professur an der SU auf und zog nach Groningen, um mich ganz der wissenschaftlichen Forschung zu widmen. Besonders am Herzen lag mir die Frage, wie sich moderne Technik nutzen ließe, um den praktischen Gesangsunterricht auf eine fundierte Grundlage zu stellen.
Die Ursprünge von VoceVista
In den 1990er Jahren hatte der Computer Einzug in die Überlegungen des Groningen Voice Research Lab gehalten, doch ich schenkte ihm wenig Beachtung. Tatsächlich war ich, Jahrgang 1933, ziemlich sicher, dass ich aus dem Alter heraus war, in dem ich mich noch mit Computern befassen würde. Dank Harm Schutte, der mich geduldig durch den Lernprozess führte, änderte ich jedoch bald meine Meinung. Personal Computer waren um diese Zeit so weit, dass sie Spektrumanalysen in ‚Echtzeit‘ durchführen konnten und unmittelbar zeigten, wie sich Formant-Tuning auf die relative Stärke der Harmonischen der Stimmquelle auswirkt. (Formanten sind die veränderlichen, dominierenden Resonanzfrequenzen des Vokaltrakts, aus denen die verschiedenen Vokalklänge entstehen.) Das Universitätsklinikum Groningen stellte Harm die Mittel zur Verfügung, ein Computerprogramm (unter MS-DOS) entwickeln zu lassen, das das Mikrofonsignal, die Spektrumanalyse und das Signal des Elektroglottographen (EGG) gleichzeitig anzeigen und aufzeichnen konnte.
Ich brannte darauf, dieses neue technische Werkzeug Gesangslehrern vorzustellen, und war zunächst überrascht, dass unsere Präsentationen auf den Symposien der Voice Foundation bei den Teilnehmern kaum Interesse zu wecken schienen. So stellten wir zum Beispiel das „Formant-Tuning“ als zentrales praktisches Mittel heraus, mit dem versierte Sänger durch Anpassung der Resonanzen des Vokaltrakts die Herausforderungen des „Passaggio“ meisterten, wenn sie die dramatischen Spitzentöne der Oper sangen. Das Grundproblem liegt darin, dass die Technik zur automatischen Bestimmung der Formantfrequenzen nach und nach versagt, je weiter die Harmonischen mit steigender Grundfrequenz auseinanderrücken. Als wir jedoch zeigten, dass sich die Formantfrequenzen durch den geschickten Einsatz von Vocal Fry dennoch zuverlässig, wenn auch nicht exakt, bestimmen lassen, stieß diese Neuigkeit auf Gleichgültigkeit. Diese Reaktion war vielleicht zu erwarten, denn die Kompetenz eines Gesangslehrers zeigt sich darin, das gewünschte Ergebnis zu hören, nicht darin, die Harmonischen der Stimmquelle auf einem Bildschirm zu sehen. Trotzdem beschloss ich, diese Forschungsrichtung weiterzuverfolgen, die sich in meinem eigenen praktischen Unterricht als äußerst vielversprechend erwies. Und auch wenn es keinen begeisterten Ansturm einer großen Schar von Gesangslehrern gab, so stieß ich doch bei einigen wenigen auf begeistertes, tiefes Interesse.
Jim Doing, ein junger amerikanischer Tenor, der 1996 in den Niederlanden lebte und dem ich gelegentlich Gesangsstunden gab, bekam eine Stelle als Gesangslehrer an der University of Missouri. Jim war der erste professionelle Sänger, der in unseren gemeinsamen Stunden ganz bewusst visuelles Feedback zum Formant-Tuning nutzte. Als man ihn nach seinen „Forschungsinteressen“ fragte, erwähnte er unsere Arbeit zum Formant-Tuning, und die Universität bot daraufhin an, solche Forschung zu finanzieren. Mit einem Teil der Mittel wurde ich samt einiger sperriger Apparaturen zu Jim und seinen Studenten geschickt, und daraus wurden ein paar erfolgreiche Wochen. Ich erinnere mich besonders an einen Tenorstudenten von Jim mit einer bemerkenswerten Stimme, der das entscheidende „Passaggio“-Manöver, das ein gezieltes Formant-Tuning ermöglicht, wunderbar vorführte.
Zufällig saß John Stuart, ein befreundeter Tenor mit einer beachtlichen Opernkarriere, der an der Washington University in St. Louis heimisch geworden war, im Planungsausschuss der bevorstehenden, alle zwei Jahre stattfindenden landesweiten Konferenz der National Association of Teachers of Singing (NATS). John kannte meine Arbeit und schlug vor, ihr einen Platz im Programm einzuräumen. Also fuhren Jim Doing, sein Vorzeigestudent und ich von Kansas City, Missouri, nach St. Louis und probten unterwegs im Auto die ganze Zeit unseren Nachmittagsvortrag. Die Resonanz war positiv. Der bekannte Bariton Ron Hedlund erklärte, er wolle VoceVista für die University of Illinois (UIUC), und Dan Ihasz, ein junger Sänger, der an der SUNY Fredonia unterrichtete, zeigte sich begeistert und machte sich über Jahre hinweg daran, die Anwendung im Gesangsunterricht und für seine eigene Gesangstechnik zu meistern. Dan arbeitet in Fredonia bis heute mit VoceVista, gemeinsam mit seinen Gesangs- und Pädagogikstudenten, von denen einige inzwischen selbst erfolgreiche Karrieren aufbauen.
Dann war da noch Garyth Nair, Chorleiter, Gesangslehrer und pädagogischer Forscher an der Drew University in Madison, NJ, der das Internet schon früh nutzte und neue Technik gern voranbrachte. Ich hatte Garyth 1997 beim Symposium der Voice Foundation kennengelernt, wo ich das ursprüngliche VoceVista vorstellte. Nach diesem ersten Treffen beschlossen wir, gemeinsam daran zu arbeiten, die Software für Gesangslehrer benutzerfreundlicher zu machen. Ein erster Schritt war, sie mit Microsoft Windows kompatibel zu machen, damals ein neues Betriebssystem. Garyth hatte schon früher Kontakt zu dem amerikanischen Ingenieur Richard Horne gehabt, der ein kostenloses Programm zur Spektrumanalyse ins Internet gestellt hatte. Eine einfache Anfrage per E-Mail genügte, und Horne war zu einem Treffen bereit, um über VoceVista zu sprechen. Doch die Sache sollte noch eine weitere Wendung nehmen. Zusätzlich zur Spektralanalyse hoffte ich, dem Programm auch elektroglottographische Fähigkeiten hinzufügen zu können (von Martin Rothenbergs Glottal Enterprises). Und so war es Richard Horne, der später sowohl die akustischen Signale als auch die EGG-Signale in die ursprüngliche Windows-Version von VoceVista integrierte.
Ein ernsthaftes Hindernis für eine breitere Nutzung des VoceVista-Systems blieb jedoch der hohe Preis des EGG, das damals ausschließlich für den medizinischen Gebrauch entwickelt und erhältlich war. Nach einigem Herumfragen fand Schutte einen findigen niederländischen Ingenieur, Gerrie Goeree, der ein einzigartiges VoceVista-EGG nachbaute und persönlich fertigte. Es lieferte hervorragende Wellenformsignale, und das zu einem Preis, den sich Sänger und Gesangslehrer leisten konnten.
Das folgende Jahrzehnt brachte Verbesserungen an unserer Software, vor allem die Integration von Richard Hornes eigener Spektrogramm-Software in VoceVista. Mit dieser neuen Technik ließen sich die Resonanzanpassungen eines Sängers in Echtzeit verfolgen, sodass man die Signale für ein Publikum projizieren konnte, das die Veränderungen sah, während der Sänger sie vornahm. Im Juni 2007 luden wir dann den Pädagogen Scott McCoy, Autor von Your Voice, an Inside View, ein, die allererste „Wired Master Class“ mit einigen Studenten von Dan Ihasz in Fredonia zu leiten. Der Kurs war ein großer Erfolg, und Scott begann noch im selben Sommer, das Programm selbst einzusetzen.
Da ich wusste, dass Scott Your Voice zuvor im Selbstverlag herausgebracht hatte, ein Buch, das die akustischen und physiologischen Grundlagen der Gesangspädagogik vermittelt, begann ich, VoceVista als Erweiterung und praktische Umsetzung der Stimmwissenschaft aus seinem Buch zu sehen. Scott war kurz zuvor zum künftigen Präsidenten der NATS gewählt worden und hatte damit Einfluss auf das Programm der Konferenz 2008 in Nashville, die alle zwei Jahre stattfindet. So traf er die mutige Entscheidung, das Programm mit einer Wired Master Class mit VoceVista zu eröffnen. Darin sah ich eine wichtige Gelegenheit, wenn nicht gar eine Verpflichtung, ein Buch zu schreiben, das als ausführliches Handbuch für die Arbeit mit VoceVista und dem EGG dienen und rechtzeitig zur NATS-Konferenz vorliegen konnte. Ich fragte Scott, ob er es lektorieren und verlegen würde, und er sagte ohne Zögern zu. So begann ich mit dem Entwurf von Resonance in Singing.
Das eigentliche Schreiben von Resonance in Singing verlief reibungslos, da ich den Großteil des Inhalts bereits in einer Reihe veröffentlichter Artikel behandelt hatte, aus denen meine Dissertation zum Ph.D. in Medizinischen Wissenschaften (Universität Groningen, 2000) mit dem Titel Registers in Singing: Empirical and Systematic Studies in the Theory of the Singing Voice hervorgegangen war. Scott erwies sich als hilfreicher und schneller Lektor, obwohl er zugleich seine Vollzeitstelle als Hochschullehrer am Westminster Choir College ausfüllte und die Präsidentschaft der NATS führte. Zwar wurde mein Schreiben im Frühjahr 2008 kurz durch eine Notoperation am Blinddarm unterbrochen, doch das Buch war rechtzeitig zur Konferenz in Nashville fertig, wo die Wired Master Class mit VoceVista als erster Programmpunkt im Plenum auf der Tagesordnung stand.
Ich glaube, man kann mit Fug und Recht sagen, dass nur wenige im Publikum wirklich verstanden, was in dieser verkürzten Master Class gezeigt wurde, aber die Verbindung von Pädagogik und Stimmwissenschaft war offensichtlich. Eine kleine Gruppe interessierter Gesangslehrer (wir nannten uns scherzhaft „Fryers“, weil wir die Formanten mithilfe von Vocal Fry aufspürten) tauschte weiterhin Informationen und Erkenntnisse aus und machte unsere alle zwei Jahre stattfindenden Workshops zu Physiologie und Akustik des Singens (PAS) in San Antonio, Stockholm und Las Vegas bekannt (nach früheren Workshops in Groningen und Denver).
Die grundlegende akustische Analysesoftware mit der zusätzlichen EGG-Funktion wurde als VoceVista Pro bekannt und ist zusammen mit dem Buch Resonance in Singing nach wie vor ein wichtiges Werkzeug für Gesangslehrer in aller Welt. Sie bildet die Grundlage einer bald erscheinenden Doktorarbeit von Stephen Robertson, dem Leiter der Voice Studies am Royal Conservatoire of Scotland. Darin geht es um seinen Einsatz des Programms im Unterricht sowie um ausgewertete Daten erfolgreicher Profis aus dem internationalen Opernbetrieb.
Obwohl VoceVista in der Welt der Gesangspädagogik immer beliebter wurde, stand ihm eine weitere Phase des Wandels bevor. Bodo Maass, der das Programm Overtone Analyzer entwickelt hatte, bot an, die VoceVista-Software zu modernisieren und zu verbessern und den grundlegenden Audio- und EGG-Signalen ein Videosignal sowie weitere technische Neuerungen hinzuzufügen. Derzeit (Januar 2020) befinden wir uns auf der Zielgeraden zum fertigen Produkt und arbeiten zudem an einer umfassenden Überarbeitung für die zweite Auflage von Resonance in Singing, damit sie zu den Neuerungen in VoceVista Video Pro passt.